Nesta página
- Cargo
- Chief Software Architect (arquiteto-chefe de software)
- Onde
- Nvidia
- Conhecido por
- Fundou a Groq, criou a LPU e participou da equipe do TPU original do Google
- O que defende
- Inferência merece hardware próprio; GPU e LPU se completam, não são rivais
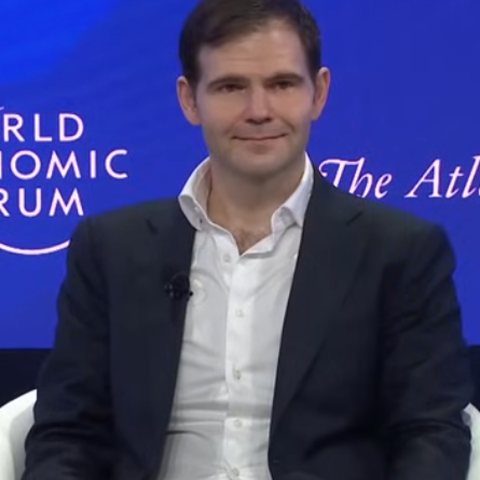
Jonathan Ross é, em novembro de 2026, Chief Software Architect (arquiteto-chefe de software) da Nvidia. Ele fundou a Groq em 2016. A empresa criou a LPU, um chip para inferência de IA. Antes, participou da equipe do TPU original do Google. Ele importa porque defende combinar GPU e LPU para gerar respostas mais rápidas.
- Ele defende combinar GPU e LPU: a GPU para paralelismo e lotes grandes, a LPU para respostas com pouca espera.
- A Nvidia fez uma licença não exclusiva, não uma compra. O DOJ investiga se a estrutura evitou o escrutínio antitruste.
Fonte principal: Jonathan Ross (podcast de David Senra) ↗
Quem é Jonathan Ross e o que ele faz hoje?
O que mudou e quando. A Nvidia anunciou uma licença não exclusiva da tecnologia de inferência da Groq e contratou Ross e outros executivos. Não anunciou uma compra integral. O valor reportado é de aproximadamente US$ 20 bilhões, segundo a CNBC. O acordo é de dezembro de 2025. A Groq continuou existindo como empresa independente, segundo a SBS.
Algumas páginas e materiais de eventos ainda o chamam de "fundador e CEO da Groq". Essa descrição está desatualizada. Fontes recentes, como a Data Center Dynamics, o descrevem como ex-CEO da Groq.
Trajetória. Segundo a CNBC, Ross participou da equipe do Google que desenvolveu o TPU original, o processador da empresa para aprendizado de máquina. Depois ele fundou a Groq, em 2016.
Por que o trabalho de Jonathan Ross importa?
🌱 Sou novo nisso. Quando você conversa com um chatbot, o modelo já está treinado. A etapa em que ele gera a resposta se chama inferência. A Groq criou um chip só para essa etapa: a LPU (Language Processing Unit). A meta é responder rápido, com pouca espera, a chamada latência.
🔎 Já uso. O modelo escreve a resposta em pedaços chamados tokens, um depois do outro. Segundo a Nvidia, a LPU é adequada para essa geração token a token e para interações de baixa latência. A GPU é mais forte em paralelismo massivo e em lotes grandes. A Groq vendia essa velocidade por meio de uma API, o GroqCloud, voltada a chatbots, agentes (IAs que executam tarefas com ferramentas) e sistemas interativos.
🚀 Já sou mais avançado. Ross divide o trabalho do modelo em duas fases. Ele explicou isso em entrevista republicada pela Futunn em 12 de junho de 2026:
- Prefill: leitura e processamento inicial do prompt. É uma fase muito paralelizável, adequada à GPU.
- Decode: geração dos tokens de saída. Pode usar GPU, GPU com LPU ou só LPU, conforme a prioridade entre custo e velocidade.
| Aspecto | GPU | LPU |
|---|---|---|
| Principal vantagem | Paralelismo massivo e lotes grandes | Baixa latência na geração token a token |
| Uso típico | Treinamento, prefill e inferência em grande escala | Decodificação interativa e inferência sensível à latência |
A DigiTimes, republicada pela TechNewsTube em 22 de junho de 2026, informou que a Nvidia pretendia combinar a LPU com a plataforma Vera Rubin. GPUs e LPUs teriam funções diferentes dentro da inferência.
O que Jonathan Ross defende?
As posições abaixo são dele, com a fonte de cada uma:
- A inferência merece hardware próprio. Segundo a CNBC, a tese de Ross era que a IA não deveria depender só de GPUs. A Groq tentou priorizar velocidade e eficiência na inferência.
- GPU e LPU se completam. Na palestra da Nvidia no GTC San Jose, em 16 de março de 2026, as duas foram apresentadas como complementares, não como rivais.
- Uma comparação com veículos. Na entrevista republicada pela Futunn, Ross comparou a GPU a um veículo pesado e a LPU a um veículo de entrega de última milha.
- A escolha segue o tipo de uso. Segundo ele, aplicações sensíveis a custo podem usar GPU. Aplicações profissionais podem usar GPU e LPU. Quem quer velocidade máxima pode preferir LPU na decodificação (Futunn).
- Eficiência é não deixar chip parado. Segundo o The Cryptonomist, Ross disse que usar só a LPU a deixaria subutilizada na atenção. Usar só a GPU a deixaria subutilizada nas camadas de feed-forward. Combinar as duas aumentaria o uso de ambas.
- Computação versus memória. No podcast de David Senra, Ross separou as partes do trabalho limitadas por computação das partes limitadas pela largura de banda de memória. Ele defendeu dividir essas partes entre GPU e LPU.
Quais são as críticas e os debates sobre o acordo com a Nvidia?
Foi uma compra disfarçada? A Nvidia chamou a operação de licenciamento não exclusivo. Em setembro de 2026, porém, a imprensa informou que o Departamento de Justiça dos EUA investigava se a estrutura poderia ter sido desenhada para evitar o escrutínio antitruste, segundo a SBS. Uma análise da National Law Review observa que licença mais contratação de talentos pode levantar a dúvida se a operação funciona, na prática, como uma fusão. Isso é uma investigação, não uma conclusão. As fontes não indicam decisão final do DOJ em novembro de 2026.
Ação de acionistas. Em outubro de 2026, a CNBC informou que acionistas da Groq processaram por causa da estrutura do acordo. Eles alegam que foram prejudicados. É uma acusação em litígio, não um fato provado.
"Mais rápido" depende do contexto. A vantagem da LPU muda conforme o modelo, o tamanho do lote, o comprimento do texto e o número de usuários ao mesmo tempo. A própria Nvidia separa a baixa latência do paralelismo em lotes grandes. As fontes consultadas não trazem uma medição independente que mostre a LPU superior às GPUs atuais em todos os casos.
O que muda para quem usa IA. O acordo pode trazer menos espera em chatbots e agentes, se os provedores adotarem a combinação GPU com LPU. Ainda não há base para afirmar que os preços de apps ou APIs vão cair. O acordo também não muda as regras de privacidade de nenhum serviço de IA. Confira os termos de cada ferramenta que você usa.
Onde ouvir Jonathan Ross: entrevistas e palestras recentes?
| Data | Veículo ou evento | Do que trata |
|---|---|---|
| 13 de março de 2026 | CNBC | Perfil do acordo, da trajetória no Google e da passagem para a Nvidia |
| 16 de março de 2026 | Nvidia GTC San Jose: "GPU ♥ LPU: Everything You Wanted to Know" | GPU para paralelismo e lotes, LPU para geração interativa |
| 13 de abril de 2026 | The Cryptonomist | Atenção na GPU e camadas de feed-forward na LPU |
| 12 de junho de 2026 | Futunn | Divisão entre prefill e decode |
| 22 de junho de 2026 | DigiTimes, via TechNewsTube | GPU e LPU complementares e a plataforma Vera Rubin |
| 5 de julho de 2026 | David Senra | Computação versus largura de banda de memória |
| 12 de novembro de 2026 | Data Center Dynamics | A estratégia da Nvidia para LPUs e o trabalho de Ross na empresa |
A palestra do GTC é a fonte mais direta, porque foi publicada pela própria Nvidia.
Perguntas frequentes
Jonathan Ross ainda é CEO da Groq?
Não. Em novembro de 2026 ele é Chief Software Architect da Nvidia, segundo a CNBC. A Groq continuou como empresa independente depois do acordo de licenciamento com a Nvidia.
O que é a LPU criada pela Groq?
É a Language Processing Unit, um chip feito para inferência, a etapa em que um modelo já treinado gera respostas. O foco é baixa latência na geração token a token.
A LPU substitui a GPU?
Não. A palestra da Nvidia de 16 de março de 2026 apresenta as duas como complementares: a GPU para paralelismo e lotes grandes, a LPU para respostas interativas com pouca espera.
A Nvidia comprou a Groq?
A Nvidia anunciou uma licença não exclusiva da tecnologia, com valor reportado de aproximadamente US$ 20 bilhões, e contratou Ross e outros executivos. O Departamento de Justiça dos EUA investiga se a estrutura serviu para evitar o escrutínio antitruste. Não há decisão final nas fontes.
Fontes
- GTC San Jose: GPU ♥ LPU: Everything You Wanted to Know (Nvidia) · oficial
- A closer look at Nvidia's $20 billion bet on tech for a new AI chip (CNBC) · prensa
- Nvidia-Groq deal stockholder lawsuit (CNBC) · prensa
- Nvidia's LPU gamble (Data Center Dynamics) · prensa
- Nvidia builds out LPU chip team following Groq deal (Data Center Dynamics) · prensa
- Nvidia-Groq deal under scrutiny (SBS News) · prensa
- Nvidia-Groq AI deal: if it quacks like a merger (National Law Review) · documento
- Groq CEO on chip architecture (Futunn) · prensa
- Groq LPU and AI inference (The Cryptonomist) · prensa
- GPU and LPU complementary (DigiTimes via TechNewsTube) · prensa
- Jonathan Ross (podcast de David Senra) · prensa