Nesta página
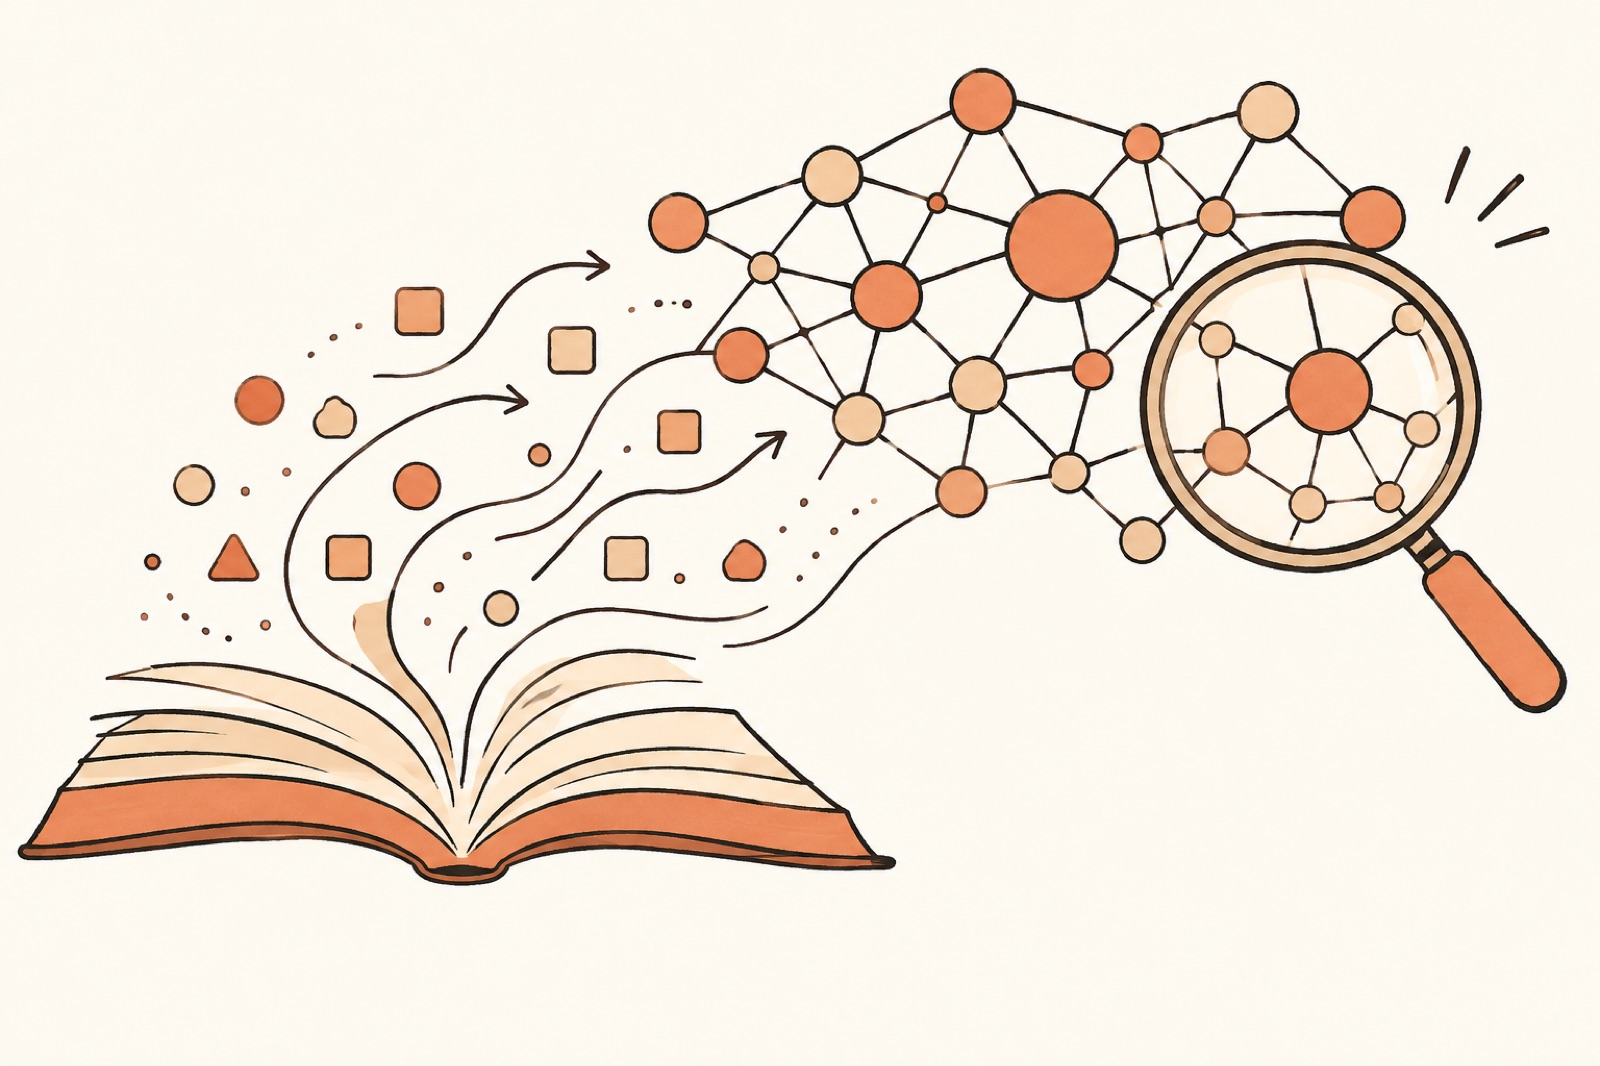
Uma rede neural artificial é um sistema matemático formado por unidades de cálculo, os neurônios artificiais, organizadas em camadas e ligadas por números chamados pesos. No treinamento, esses pesos são ajustados aos poucos para que a rede erre menos. É assim que modelos aprendem tarefas como prever a próxima palavra de um texto.
- Cada neurônio multiplica entradas por pesos, soma, acrescenta um viés e aplica uma função de ativação.
- No treinamento, uma função de perda mede o erro e os pesos são ajustados aos poucos para a rede errar menos.
- A rede não pensa como um cérebro: executa operações numéricas. Parâmetros e hiperparâmetros são coisas diferentes.
O que é rede neural artificial e de onde vem o nome?
É um conjunto de pequenas contas matemáticas ligadas entre si, que aprende ajustando números internos.
🌱 Sou novo nisso. O nome vem da inspiração no cérebro. Os pesquisadores Warren McCulloch e Walter Pitts propuseram em 1943 um modelo matemático de neurônio, no artigo "A logical calculus of the ideas immanent in nervous activity", publicado no Bulletin of Mathematical Biophysics. É um ponto de partida clássico da área.
A inspiração é só isso: uma inspiração. Um neurônio artificial não é uma célula viva. Ele recebe números, faz uma conta e passa o resultado adiante.
Hoje o termo descreve redes muito maiores. Uma reportagem da revista Nature de 13 de novembro de 2026 descreve as redes modernas como sistemas de neurônios ligados por bilhões de pesos, ajustados gradualmente para tarefas como prever estruturas de proteínas ou a próxima palavra de um texto (Nature).
Como funciona uma rede neural com neurônios, pesos e camadas?
🔎 Já uso. Imagine uma sequência de filtros organizada em camadas:
1. Camada de entrada: recebe os dados, como os pixels de uma imagem ou palavras transformadas em números. 2. Camadas ocultas: combinam esses números e destacam padrões. 3. Camada de saída: entrega a resposta, como "gato", "cachorro" ou a próxima palavra.
Cada neurônio artificial faz uma conta simples. Ele multiplica cada entrada por um peso, soma tudo, acrescenta um ajuste chamado viés (bias) e aplica uma função de ativação:
saída = f(peso1 × entrada1 + peso2 × entrada2 + … + viés)
Os pesos indicam quanto cada conexão influencia a próxima:
- peso positivo tende a aumentar a ativação seguinte;
- peso negativo tende a reduzi-la;
- peso perto de zero tem pouca influência.
Como a rede aprende. O treinamento segue um ciclo que se repete muitas vezes:
1. a rede recebe um exemplo; 2. calcula uma resposta; 3. uma função de perda mede o erro em relação ao resultado esperado; 4. o erro é propagado de volta pela rede; 5. os pesos são ajustados para errar menos.
🚀 Já sou mais avançado. Esse passo de levar o erro de volta é a retropropagação, e ela não é a única opção estudada. Um artigo da PNAS Nexus publicado em 30 de setembro de 2026 apresentou o método product feedback alignment. Ele busca treinar sem a simetria explícita entre os pesos do caminho de ida e os do caminho de volta. Para isso, usa uma população extra de neurônios no caminho de retorno e mira um desempenho comparável ao treinamento convencional em redes convolucionais profundas (PNAS Nexus). A ideia básica não muda: a rede aprende ajustando números internos.
Quais são as confusões mais comuns sobre redes neurais?
- "A rede pensa como um cérebro." Não. Ela executa operações numéricas. A analogia com neurônios biológicos ajuda a entender a estrutura, mas não descreve consciência nem raciocínio humano.
- "Parâmetros e hiperparâmetros são a mesma coisa." Não são. Parâmetros são os pesos e vieses que o modelo aprende. Hiperparâmetros são escolhas de quem desenvolve a rede, como a taxa de aprendizado, o tamanho das camadas e o número de rodadas de treino.
- "Pesos são regras escritas." Não. Os pesos treinados são os valores numéricos guardados no modelo depois do treinamento. Eles não funcionam como um manual que alguém possa ler.
- "Mais camadas sempre dão um resultado melhor." Mais camadas tornam a rede mais profunda, mas isso não garante qualidade. O comportamento final também depende dos dados, da arquitetura, do treinamento e do uso.
- "Pesos abertos é o mesmo que código aberto." Quando uma empresa publica só os pesos treinados de um modelo, o termo correto é pesos abertos (open weights). Código aberto é outra coisa.
Conceitos conferidos em nov/2026.
Perguntas frequentes
Rede neural e cérebro humano funcionam do mesmo jeito?
Não. A rede neural artificial se inspira na ideia de neurônios conectados, mas cada neurônio artificial é uma conta matemática. Ela não tem consciência e não raciocina como uma pessoa.
O que são os pesos de uma rede neural?
São números que indicam a força de cada conexão entre neurônios. O treinamento ajusta esses números aos poucos para que a rede erre menos em tarefas como prever a próxima palavra de um texto.
O que é uma camada oculta?
É uma camada entre a entrada e a saída. Ela faz transformações intermediárias nos dados e ajuda a rede a destacar padrões antes de produzir a resposta final.
Como uma rede neural aprende?
Ela recebe exemplos, calcula uma resposta e mede o erro com uma função de perda. Depois ajusta os pesos para reduzir esse erro e repete o ciclo muitas vezes.
Fontes
- McCulloch e Pitts, A logical calculus of the ideas immanent in nervous activity (Bulletin of Mathematical Biophysics, v. 5, 1943) · academica
- Nature: reportagem sobre pesos e neurônios em redes profundas (13 de novembro de 2026) · prensa
- PNAS Nexus: product feedback alignment, treinamento sem simetria explícita de pesos (30 de setembro de 2026) · academica