Nesta página
IA multimodal é a que trabalha com mais de um tipo de dado no mesmo pedido: texto, imagem, áudio ou vídeo. Por isso um assistente consegue descrever uma foto ou responder por voz. Receber vários tipos de dado (entrada) não significa gerar todos eles (saída). Cada modelo cobre uma combinação diferente.
- O Gemini 4 Hydrogen lista as quatro entradas. O gpt-realtime-2.1 e o Qwen3.5-Omni-Plus-Realtime focam em áudio em tempo real.
- Modelos multimodais também erram: podem inventar detalhes de uma imagem com confiança.
Fonte principal: Google Cloud — Model Garden pricing ↗
De onde vem o termo IA multimodal?
🌱 Sou novo nisso
"Modalidade" é um tipo de dado: texto, imagem, áudio ou vídeo. Um modelo que trabalha só com texto é de uma modalidade. Um modelo multimodal combina mais de um tipo no mesmo pedido. Por exemplo, você manda uma foto e pergunta o que aparece nela.
A IA não "vê" nem "ouve" como uma pessoa. Ela converte a foto ou o som em números e calcula uma resposta a partir deles.
🔎 Já uso
Na pesquisa, o nome técnico é MLLM, sigla em inglês para modelo de linguagem multimodal. Um capítulo publicado como preprint no arXiv descreve os desafios do processamento conjunto de diferentes modalidades. O mesmo texto separa esses modelos dos que trabalham apenas com texto e imagem.
🚀 Já sou mais avançado
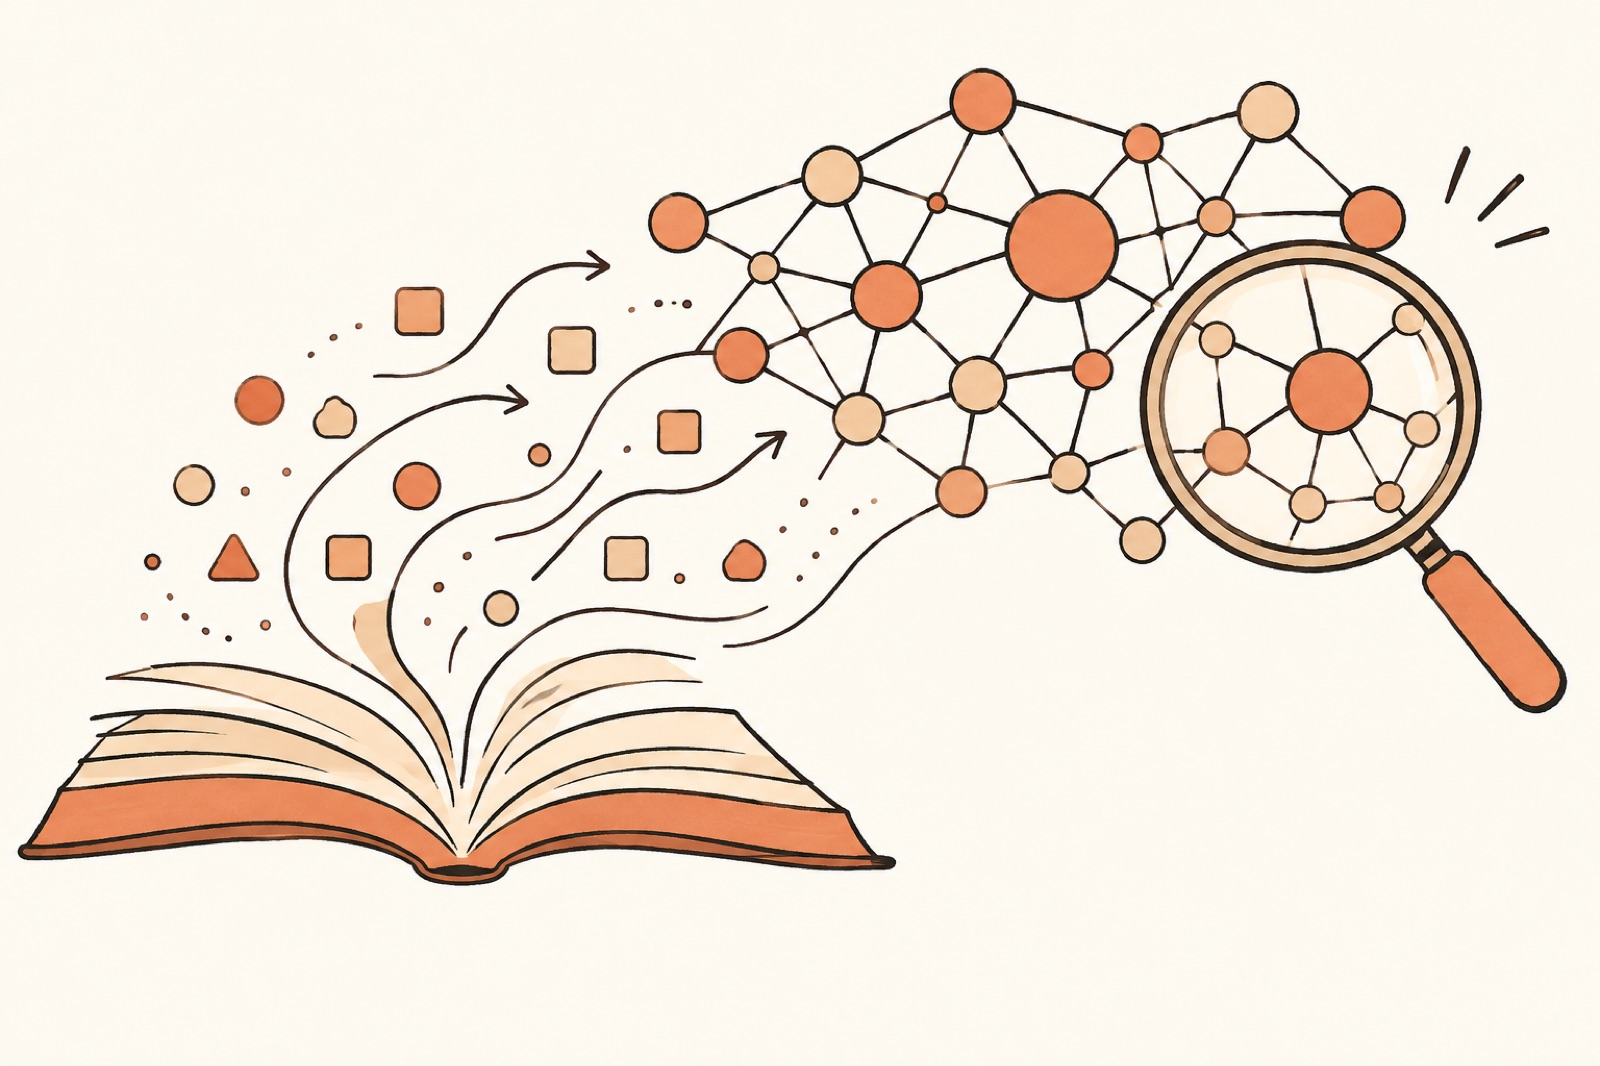
O mesmo preprint explica o problema central. Cada modalidade tem uma representação numérica própria: tokens para texto, pixels para imagem, sinais para áudio. Esses formatos não são comparáveis diretamente.
A solução usual é o alinhamento de embeddings. Embeddings são vetores, ou seja, listas de números que representam o significado de um conteúdo. Esse alinhamento coloca as modalidades num espaço compartilhado. Nesse espaço, a palavra "cachorro", a foto de um cachorro e o som de um latido ficam em regiões vizinhas.
Na arquitetura mais comum, o modelo de linguagem funciona como centro. A ele se conectam encoders, componentes especializados que convertem imagem ou áudio em vetores (fonte).
Como a IA multimodal aparece nos modelos atuais?
Comparamos três empresas com os mesmos critérios: o que o modelo recebe e o que a fonte confirma sobre saída e vídeo. A API é o acesso pago para desenvolvedores. Tudo foi verificado em nov/2026, nas páginas oficiais de preço de cada empresa.
Os preços de API por milhão de tokens mudam com frequência: veja a comparação de preços de API.
| Modelo (empresa) | Entrada indicada na fonte | Saída e vídeo | Fonte |
|---|---|---|---|
| Gemini 4 Hydrogen (Google, lançado em 2026-11-12) | Texto, imagem, vídeo e áudio | A fonte não demonstra geração das quatro modalidades | Google Cloud, atualizada em 13 de novembro de 2026 |
| gpt-realtime-2.1 (OpenAI) | Preços separados para áudio, texto e imagem | A fonte não comprova vídeo no mesmo modelo | OpenAI, atualizada em 13 de novembro de 2026 |
| Qwen3.5-Omni-Plus-Realtime (Alibaba/Qwen) | Texto/imagem e áudio, com geração de áudio | O trecho consultado não confirma vídeo como entrada | Qwen Cloud, atualizada em 13 de novembro de 2026 |
O que muda entre eles
- Gemini 4 Hydrogen: foi o exemplo mais claro com as quatro entradas listadas juntas.
- gpt-realtime-2.1: a página de preços indica foco em áudio em tempo real.
- Qwen: a página informa escopo de implantação "US" para alguns produtos. Isso não permite concluir que todos os recursos estejam disponíveis em todos os lugares.
Outros fornecedores
Anthropic (Claude), xAI (Grok), DeepSeek e Mistral têm preços na lista oficial consultada em 14 de novembro de 2026. Sobre as modalidades desses modelos, não encontramos fonte oficial atual nesta verificação. Por isso, a página não afirma o que eles aceitam.
E os aplicativos?
As fontes tratam de APIs. Não confirmam quais recursos multimodais cada aplicativo oferece, nem em qual plano.
Quais são as confusões comuns sobre IA multimodal?
- Entrada não é saída. Aceitar texto, imagem, áudio e vídeo não prova que o modelo também gera os quatro. As fontes consultadas não demonstram isso para os modelos da tabela.
- Aplicativo não é modelo. Um assistente pode juntar vários modelos especializados, como um de linguagem, um de visão e um de voz. Nesse caso, nenhum modelo único cuida de tudo. As fontes não permitem dizer como cada aplicativo é montado.
- Multimodal também erra. O preprint do arXiv cita as alucinações multimodais: o modelo pode inventar detalhes de uma imagem com confiança (fonte). Confira o que importa antes de usar a resposta.
- Cada tipo de dado tem um preço. Mandar áudio ou vídeo pode custar bem mais que mandar texto.
- Ranking não decide sozinho. Uma medição de compreensão de imagens não mostra competência em áudio e vídeo. Não encontramos comparação homogênea e verificável entre esses três modelos no LMArena, no Epoch AI ou no Artificial Analysis.
Perguntas frequentes
Todo assistente de IA é multimodal?
Não dá para afirmar. As fontes oficiais consultadas em nov/2026 tratam de APIs. Elas não confirmam, para cada assistente, quais tipos de dado ele aceita ou gera, nem em qual plano.
Qual é o melhor modelo multimodal?
Nenhum modelo é o melhor para tudo. O Gemini 4 Hydrogen lista as quatro entradas. O gpt-realtime-2.1 e o Qwen3.5-Omni-Plus-Realtime têm documentação voltada a áudio em tempo real. Não encontramos comparação homogênea e verificável entre eles, então compare para a sua tarefa (verificado em nov/2026).
É seguro mandar fotos e áudios para a IA?
Privacidade e segurança vêm primeiro. Antes de enviar uma foto, um documento ou a sua voz, veja o que cada ferramenta faz com esses dados. Se a imagem for um exame ou um contrato, a IA pode ajudar a entender, mas a decisão é com um profissional.
Por que a IA consegue descrever uma foto?
A foto é convertida em vetores numéricos e colocada no mesmo espaço que o texto. Assim, o modelo de linguagem consegue gerar uma descrição a partir desses números. Ele faz cálculos, não enxerga como uma pessoa.
Fontes
- Grandes Modelos de Linguagem Multimodais (MLLMs): Da Teoria à Prática (preprint, arXiv) · academica
- Google Cloud — Model Garden pricing · oficial
- OpenAI — API pricing · oficial
- Qwen Cloud — Model prices · oficial